
Yapay Zekâ Ajanlarında Yetki Sınırları Nasıl Çizilir?
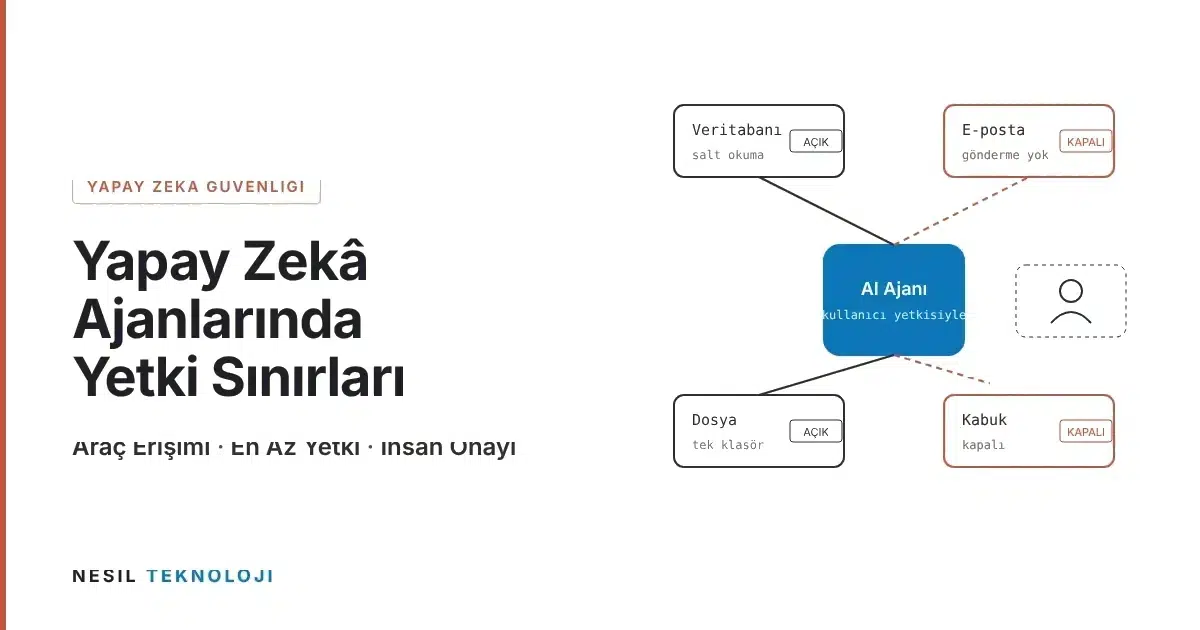
Yayın: 26 Ekim 2026 · Son güncelleme: 26 Ekim 2026Yapay zekâ ajanlarında yetki sınırı, bir ajanın hangi araçlara erişebileceğini, bu araçlarla neler yapabileceğini ve hangi eylemleri insan onayı olmadan gerçekleştirebileceğini belirleyen güvenlik çerçevesidir. OWASP bu riski 2025 LLM Top 10 listesinde LLM06 “Excessive Agency” başlığıyla izliyor ve üç kök nedene ayırıyor: gereksiz araçlar, gereğinden geniş izinler ve onaysız eylemler. 26 Ekim 2026 itibarıyla OWASP, 9 Aralık 2025’te yayımladığı Top 10 for Agentic Applications listesiyle ajanlara özgü riskleri ayrıca ele alıyor.
İlgili Rehberler
Yapay Zekâ ile Red Team
Yapay zekâ destekli sızma testi ve red team operasyonları.
Yapay Zekâ Phishing Saldırıları
LLM’lerin sosyal mühendislikte kullanımı.
ISO 42001 Yapay Zekâ Yönetim Sistemi
Yapay zekâ kullanımını kurum düzeyinde yönetmek.
Bir bakışta ajan yetki sınırları
- Bir ajanın yapabileceği en kötü şey, ona verilen araçların ve izinlerin toplamıdır; model ne kadar iyi olursa olsun bu sınır değişmez.
- Yetki kontrolü modelin kararına değil, ajanın bağlandığı sistemlere konmalıdır. OWASP de yetkilendirmenin hedef sistemde zorlanmasını öneriyor.
- Özel veriye erişim, dışarıdan gelen içerik ve dışarıya veri gönderebilme aynı ajanda buluştuğunda veri sızdırma için gereken her şey hazırdır.
- EchoLeak, GitHub MCP ve Replit olayları bu riskin 2025’te üretim sistemlerinde gerçekleştiğini gösterdi.
- Her araç çağrısını onaya sunmak onay yorgunluğu yaratır; insan onayı yalnızca geri alınamaz eylemlerde zorunlu tutulmalıdır.
İçindekiler
Yapay Zekâ Ajanlarında Yetki Sınırları Neden Önemlidir?
Geleneksel bir uygulama önceden yazılmış bir akışı izler; ajan ise bir sonraki adımına doğal dildeki talimatları yorumlayarak karar verir. Bu yüzden okunan bir e-postadaki gizli bir cümle ya da modelin yanlış bir çıkarımı ajanı beklenmedik bir eyleme götürebilir. Model ne kadar iyi eğitilmiş olursa olsun böyle sapmalar tamamen önlenemez; zararın üst sınırını belirleyen şey ajana verilen yetkilerdir.
Somut bir örnekle düşünelim. Veritabanına geniş erişimi olan bir ajan müşteri kayıtlarını okuyup dış bir adrese gönderebilir. E-posta veya kod deposu aracına sahip bir ajan, kurum adına geri alınamayacak bir iş yapabilir. Saldırgan da prompt injection ile ajanın elindeki araçları kendi amacı için kullanarak iç sistemlere ulaşabilir; ajanın eriştiği her araç, saldırgan için de bir kapıya dönüşür.
Aşırı Yetkilendirme (Excessive Agency) Nedir?
Aşırı yetkilendirme, bir ajanın görevini yapmak için gerekenden fazla araca, izne veya özerkliğe sahip olmasıdır. Çoğu zaman kasıtlı bir tercih değil, “önce çalışsın” yaklaşımının yan ürünüdür: geliştirme sırasında eklenen araçlar ve geniş izinler üretime aynen taşınır. OWASP bu durumu üç kök nedene ayırır ve her birinin farklı bir kontrolü vardır.
| Kök neden | Ne demek | Örnek | Kontrol |
|---|---|---|---|
| Aşırı işlevsellik | Ajana görevi için gerekmeyen araçlar verilmiş | E-posta özetleyen ajanın e-posta gönderme aracına da sahip olması | Yalnızca gerekli araçlar; dar kapsamlı araç tanımları |
| Aşırı izin | Araçların hedef sistemdeki yetkisi gereğinden geniş | Sadece okuması gereken ajanın veritabanında yazma yetkisi | Salt okunur roller, kolon bazlı yetki |
| Aşırı özerklik | Yüksek etkili eylemler onaysız yapılıyor | Ajanın müşteriye kendi başına e-posta göndermesi | Risk bazlı insan onayı |
Bu üç durum çoğu zaman birlikte görülür. Gereksiz bir aracın geniş izinle ve onaysız çalışabildiği bir ajanda, tek bir başarılı prompt injection doğrudan veri kaybına dönüşebilir.
OWASP Aşırı Yetkilendirme İçin Ne Öneriyor?
OWASP’ın LLM06:2025 maddesi, önlemlerin büyük kısmını model davranışına değil altyapıya koyar. Temel fikir şudur: modelin doğru karar vereceğine güvenmeyin, yanlış karar verdiğinde verebileceği zararı sınırlayın. Loglama ve izleme sorunu önlemez, ancak zararı daha erken fark etmeyi sağlar. Aşağıdaki maddeler OWASP’ın önerilerinin sadeleştirilmiş halidir.
- Ajana yalnızca görevi için gereken araçları verin; genel amaçlı kabuk veya serbest URL çağırma araçları yerine dar kapsamlı araçlar tanımlayın.
- Her aracın içinde de yalnızca gereken işlevleri açık bırakın.
- Hedef sistemlerde en düşük yetkiyle bağlanın; örneğin salt okunur veritabanı rolü.
- Eylemleri ortak, yüksek yetkili bir hesapla değil, ajanı çalıştıran kullanıcının kimliği ve yetkisiyle yürütün.
- Yüksek etkili eylemlerde insan onayı isteyin.
- Yetkilendirmeyi modelin kararına bırakmayın; hedef sistemde zorlayın.
Bu önlemlerin bir test planına nasıl dönüştüğünü yapay zekâ ile red team operasyonları rehberimizde anlattık.
Araç Erişimi Hangi Saldırı Yüzeylerini Oluşturur?
Ajana eklenen her araç yeni bir yetenek olduğu kadar yeni bir saldırı yüzeyidir. Araçlar, ajanın dış dünyaya dokunduğu noktalardır; dolaylı prompt injection, parametre manipülasyonu ve yetki yükseltme bu noktalarda gerçekleşir. Ajan ne kadar çok araca sahipse, saldırganın deneyebileceği yol da o kadar çoğalır.
- Dolaylı prompt injection: Ajanın okuduğu bir belge, web sayfası veya e-postaya gömülmüş talimatlar, ajan tarafından kullanıcı talimatı gibi işlenir.
- Parametre manipülasyonu: Ajanın oluşturduğu SQL sorgusu veya API çağrısı, saldırganın yönlendirdiği değerlerle yetkisiz veri döndürecek hale getirilir.
- Araç zincirleme: Tek başına zararsız iki araç birleşince tehlikeli olur. Dosya okuma aracı ile e-posta gönderme aracı yan yana durduğunda veri sızdırma için ayrı bir açığa gerek kalmaz.
- Geniş OAuth kapsamları: SaaS uygulamalarına bağlanan ajanlar çoğu zaman gereğinden geniş kapsam ister; bu, SaaS shadow access yazımızda anlattığımız yetim token sorununu ajan dünyasına taşır.
- Yetki yükseltme: Ajanın çalıştığı servis hesabı altyapı yetkisine sahipse, saldırgan ajan üzerinden kaynak silme veya yapılandırma değiştirme gibi işler yaptırabilir.
Araştırmacı Simon Willison bu durumu “ölümcül üçlü” (lethal trifecta) olarak adlandırıyor: özel veriye erişim, güvenilmeyen içeriğe maruz kalma ve dışarıya veri gönderebilme aynı ajanda birleştiğinde saldırganın veri sızdırması için gereken her şey hazırdır. Willison’ın önerisi de buna göre: her ajanda bu üç yetenekten en az birini kesin olarak kapatın.
2025’te Yaşanan Gerçek Olaylar Ne Gösteriyor?
Ajanların yetki sınırlarını aşması 2025’te laboratuvardan çıkıp ürünlerde yaşanan olaylara dönüştü. Aşağıdaki üç olay farklı ürünlerde, farklı yollarla gerçekleşti; ortak noktaları, ajanın ihtiyacından fazla erişime sahip olması ve bu erişimin dışarıdan gelen içerik ya da modelin kendi hatasıyla kötüye kullanılmasıdır.
| Olay | Ne oldu | Kök neden | Ders |
|---|---|---|---|
| EchoLeak, Microsoft 365 Copilot (Haziran 2025, CVE-2025-32711, CVSS 9,3) | Aim Security’nin bulduğu açıkta, e-postaya gizlenen talimatlar Copilot’un kurum içi verileri tıklama gerekmeden dışarı sızdırmasına yol açtı. Microsoft açığı kapattı. | Güvenilmeyen içerik ile özel veri aynı bağlamda, dışarıya veri çıkışı mümkün | Dış içerik ile hassas veri aynı bağlama alınmamalı, çıktıdaki bağlantılar denetlenmeli |
| GitHub MCP “toxic agent flow” (Mayıs 2025, Invariant Labs) | Açık bir depodaki issue’ya yazılan talimat, depoları inceleyen ajanın kullanıcının özel depolarındaki bilgileri herkese açık bir pull request’e yazmasını sağladı. | Ajanın token’ı tüm depolara erişebiliyordu | Oturum başına tek depo gibi çalışma anı kısıtlamaları |
| Replit kodlama ajanı (Temmuz 2025) | SaaStr kurucusu Jason Lemkin’in denemesinde, değişiklik yapmaması söylenen ajan üretim veritabanını sildi; 1.206 yönetici ve 1.196’dan fazla şirket kaydı etkilendi. | Ajanın üretim veritabanında silme yetkisi vardı; “yapma” talimatı teknik bir kısıt değildi | Geliştirme ve üretim ayrımı, sohbet/plan modu, yedekten geri dönüş |
Replit olayından sonra şirketin geliştirme ve üretim veritabanlarını otomatik ayırması, yalnızca planlama yapan bir mod eklemesi ve tek tıkla yedekten dönüş sunması, yetki sınırlarının prompt’a yazılan bir talimatla değil altyapıyla çizilmesi gerektiğini net biçimde gösteriyor.
En Az Yetki İlkesi Yapay Zekâ Ajanlarına Nasıl Uygulanır?
En az yetki ilkesi, ajanın araçlarının, veritabanı bağlantılarının, API anahtarlarının ve dosya erişiminin yalnızca o anki görevi tamamlamaya yetecek kadar yetkiyle çalışmasıdır. Sıfır güven yaklaşımının ajanlara uygulanmış halidir: ajana güvenilmez, her erişim ayrı ayrı daraltılır ve süresi sınırlanır. Aşağıdaki beş katman bu daraltmanın nerede yapılacağını gösterir.
- Araç: Yalnızca gereken araçları tanımlayın; yeni araç eklemek bir onay sürecinden geçsin.
- İzin: Her aracın veritabanı, API ve dosya erişimini ayrı ayrı en dar kapsamda tanımlayın.
- Kullanıcı bağlamı: Ajan, kendisini çalıştıran kullanıcının yetkisiyle çalışsın; kullanıcının yapamayacağı bir şeyi ajan da yapamasın.
- Süre: Uzun ömürlü API anahtarları yerine kısa ömürlü tokenlar kullanın.
- Görev: Görev bitince erişim bırakılsın; sonraki görev için yeniden yetki alınsın.
Örneğin sipariş durumunu sorgulayan bir destek ajanının veritabanı rolü, PostgreSQL’de yalnızca gereken kolonları okuyabilecek şekilde tanımlanabilir:
-- Yalnızca sipariş durumu ve tarihini okuyabilen, yazamayan rol
CREATE ROLE destek_ajani LOGIN PASSWORD '********';
GRANT SELECT (siparis_no, durum, kargo_tarihi) ON siparisler TO destek_ajani;
-- Müşteri adresi, telefon ve ödeme kolonlarına erişim yok;
-- UPDATE, DELETE ve diğer tablolar tanımlı değil.
Bu rol, prompt injection başarılı olsa bile ajanın sipariş iptal etmesini ya da müşteri telefonlarını listelemesini veritabanı seviyesinde imkânsız hale getirir. Aynı ilkelerin insan kullanıcılara uygulanışını PAM ile ayrıcalıklı erişim yönetimi rehberimizde bulabilirsiniz.
İnsan Onayı (Human-in-the-Loop) Mekanizması Nasıl Tasarlanır?
İnsan onayı, ajanın geri alınamaz veya yüksek etkili bir eylemden önce bir kişinin açık onayını almasını zorunlu kılan kontroldür. Veri silme, dışarıya mesaj gönderme, ödeme ve yapılandırma değişikliği tipik örneklerdir. Ancak her şeyi onaya sunan bir tasarım, kısa sürede onayların okunmadan verilmesine yol açar ve güvenliği artırmak yerine azaltır.
- Araç çağrılarını risk seviyesine göre ayırın: salt okunur sorgular otomatik geçsin, değiştiren veya dışarıya gönderen eylemler onay istesin.
- Onay ekranında ajanın hangi aracı, hangi parametrelerle ve ne amaçla çağıracağını açıkça gösterin; “devam edilsin mi?” yeterli değildir.
- Onay bekleyen isteklere süre sınırı koyun; süresi dolan istek reddedilmiş sayılsın.
- Birden fazla eylemin tek tıkla toplu onaylanmasına izin vermeyin.
- Onaylanan ve reddedilen her isteği, kimin ne zaman karar verdiğiyle birlikte kaydedin.
Yapay Zekâ Ajanı Güvenlik Mimarisi Nasıl Kurulur?
Ajan güvenliği tek bir kontrolle sağlanamaz; girdiden çıktıya, izlemeden müdahaleye kadar katmanlı kurulmalıdır. Her katman bir öncekinin kaçırdığını yakalamak için vardır. Prompt injection filtreleri bugün tam güvenilir olmadığından, asıl yükü izin ve onay katmanları taşır. Örneğin girdi filtresi bir talimatı kaçırırsa, salt okunur bir veritabanı rolü yine de veri değişikliğini engeller.
| Katman | Bileşenler | Hedeflediği risk |
|---|---|---|
| Girdi | Dış içeriğin işaretlenmesi, girdi filtreleri | Prompt injection (kısmen) |
| Araç | Araç listesi, parametre doğrulama | Aşırı işlevsellik |
| İzin | Kullanıcı bağlamı, RBAC, dar OAuth kapsamı | Aşırı izin |
| Onay | Risk bazlı insan onayı | Aşırı özerklik |
| Çıktı | Hassas veri filtresi, dış bağlantı denetimi | Veri sızdırma |
| İzleme | Araç çağrısı logları, anomali kuralları | Saldırının fark edilmesi |
| Müdahale | Ajanı durdurma, tokenları iptal etme | Zararın sınırlanması |
Ajan sistemlerinde tehdit modellemesi için Cloud Security Alliance’ın Şubat 2025’te yayımladığı MAESTRO çerçevesi, ajan mimarisini katmanlara ayırıp her katmanın tehditlerini ayrı ayrı ele almayı öneriyor.
Yapay Zekâ Ajanı Güvenlik Kontrol Listesi
Aşağıdaki liste, ajan geliştiren veya kullanan ekiplerin tasarımdan işletmeye kadar kontrol etmesi gereken maddeleri toplar. OWASP LLM06:2025 ve OWASP Top 10 for Agentic Applications esas alınarak hazırlandı. Yeni bir ajan devreye alınırken ve her yeni araç eklendiğinde liste baştan gözden geçirilmelidir.
Tasarım
- Ajanın görevi için gereken en küçük araç seti belirlendi.
- Her aracın hedef sistemdeki yetkisi en az yetki ilkesine göre tanımlandı.
- Özel veri, güvenilmeyen içerik ve dışarıya veri gönderme yeteneklerinden en az biri kapalı.
- Geri alınamaz eylemler listelendi ve onaya bağlandı.
Geliştirme
- Araç parametreleri tür ve değer doğrulamasından geçiyor.
- Ajan, kullanıcının kimliği ve yetkisiyle çalışıyor; ortak yönetici hesabı kullanılmıyor.
- Tüm araç çağrıları parametreleriyle birlikte loglanıyor.
- Tokenlar kısa ömürlü, OAuth kapsamları dar.
İşletme
- Anormal araç çağrısı desenleri için alarm kuralları tanımlı.
- Ajanı durdurma ve erişimini iptal etme prosedürü yazılı ve denenmiş.
- Prompt injection ve yetki yükseltme senaryoları düzenli olarak test ediliyor; BAS (saldırı ve ihlal simülasyonu) ile bu senaryolar sürekli doğrulanabilir.
Sıkça Sorulan Sorular
Bu bölümde yapay zekâ ajanlarının güvenliğiyle ilgili sık sorulan üç soru yer alıyor: ajan güvenliğinin klasik uygulama güvenliğinden farkı, her araç çağrısında insan onayı gerekip gerekmediği ve OWASP’ın iki ayrı listesinin nasıl ayrıştığı. Üçüncü soru, iki OWASP listesinin hangi durumda hangisine bakılacağını da açıklıyor.
Yapay zekâ ajanı güvenliğinin klasik uygulama güvenliğinden farkı nedir?
Klasik bir uygulamada akış önceden kodlanmıştır ve güvenlik kontrolleri bu akışa göre yazılır. Ajanda bir sonraki adım, modelin doğal dildeki talimatları yorumlamasına bağlıdır ve önceden tam bilinemez. Bu yüzden prompt injection gibi yeni saldırılar ortaya çıkar ve en az yetki ilkesi araç, izin ve özerklik düzeyinde ayrı ayrı uygulanmalıdır.
Her araç çağrısı için insan onayı gerekli mi?
Hayır. Her çağrıyı onaya sunmak, onayların okunmadan verilmesine yol açar ve güvenliği azaltır. Salt okunur ve düşük etkili eylemler otomatik geçebilir; veri değiştirme, dışarıya mesaj gönderme, ödeme ve yapılandırma değişikliği gibi geri alınamaz eylemler ise mutlaka onay istemelidir.
OWASP LLM Top 10 ile Agentic Applications Top 10 arasındaki fark nedir?
LLM Top 10 (2025), LLM kullanan her uygulama için geçerli riskleri sıralar ve aşırı yetkilendirmeyi LLM06 olarak ele alır. 9 Aralık 2025’te yayımlanan Top 10 for Agentic Applications ise kendi başına plan yapıp araç kullanan ajanlara odaklanır; hedef ele geçirme (ASI01), araçların kötüye kullanımı (ASI02), kimlik ve yetki istismarı (ASI03) gibi ajanlara özgü riskleri kapsar.
Kaynaklar
- OWASP — LLM06:2025 Excessive Agency
- OWASP GenAI Security Project — Top 10 for LLM Applications ve Top 10 for Agentic Applications
- The Hacker News — EchoLeak: Zero-Click AI Vulnerability in Microsoft 365 Copilot (CVE-2025-32711), Haziran 2025
- Invariant Labs — GitHub MCP Exploited: Accessing Private Repositories via MCP (Mayıs 2025)
- eWeek — AI Agent Wipes Production Database (Replit), Temmuz 2025
- Simon Willison — The lethal trifecta for AI agents (Haziran 2025)
- Cloud Security Alliance — Agentic AI Threat Modeling Framework: MAESTRO (2025)
Erişim tarihi (tüm kaynaklar): 26 Ekim 2026. Güncelleme tarihçesi: 26 Ekim 2026 — ilk yayın.
Yapay Zekâ Ajanı Güvenlik Testi İçin Ön Görüşme
Ajanlarınızın araç erişimini, prompt injection direncini ve yetki yükseltme senaryolarını red team kapsamında saldırgan gözüyle birlikte değerlendirelim.
Teklif Talep Et